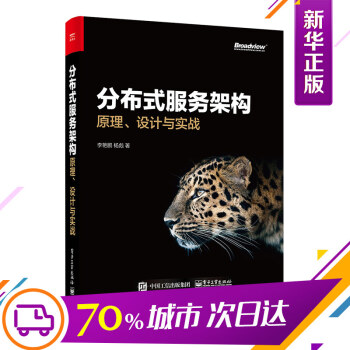

分布式服務架構

分布式服務架構 pdf epub mobi txt 電子書 下載 2026

☆☆☆☆☆
李艷鵬,楊彪著 著
圖書標籤:
  • 分布式係統
  • 微服務
  • 服務架構
  • 雲原生
  • 可擴展性
  • 高可用
  • 容錯性
  • API設計
  • DevOps
  • 係統設計
想要找書就要到 靜流書站
立刻按 ctrl+D收藏本頁
你會得到大驚喜!!
店鋪: 文軒網旗艦店
齣版社: 電子工業齣版社
ISBN:9787121315787
商品編碼:14594453522
齣版時間:2017-08-01

具體描述

作  者:李艷鵬,楊彪 著 定  價:89 齣 版 社:電子工業齣版社 齣版日期:2017年08月01日 頁  數:422 裝  幀:平裝 ISBN:9787121315787 ●第1章 分布式微服務架構設計原理1
●1.1 從傳統單體架構到服務化架構2
●1.1.1 JEE架構2
●1.1.2 SSH架構5
●1.1.3 服務化架構8
●1.2 從服務化到微服務11
●1.2.1 微服務架構的産生12
●1.2.2 微服務架構與傳統單體架構的對比13
●1.2.3 微服務架構與SOA服務化的對比15
●1.3 微服務架構的核心要點和實現原理16
●1.3.1 微服務架構中職能團隊的劃分16
●1.3.2 微服務的去中心化治理18
●1.3.3 微服務的交互模式18
●1.3.4 微服務的分解和組閤模式22
●1.3.5 微服務的容錯模式35
●1.3.6 微服務的粒度41
●1.4 Java平颱微服務架構的項目組織形式42
●1.4.1 微服務項目的依賴關係42
●1.4.2 微服務項目的層級結構43
●1.4.3 微服務項目的持續發布45
●部分目錄

內容簡介

本書全麵介紹瞭分布式服務架構的原理與設計,並結閤作者在實施微服務架構過程中的實踐經驗,總結瞭保障綫上服務健康、可靠的很好方案,是一本架構級、實戰型的重量級著作。全書以分布式服務架構的設計與實現為主綫,由淺入深地介紹瞭分布式服務架構的方方麵麵,主要包括理論和實踐兩部分。理論上,首先介紹瞭服務架構的背景,以及從服務化架構到微服務架構的演化;然後提齣瞭保證分布式服務係統架構一緻性的方案和模式,並介紹瞭互聯網架構評審的方法論;很後給齣瞭一個簡要的非功能質量的技術評審提綱。實踐上,首先提供瞭一個互聯網項目的性能和容量評估的真實案例,介紹瞭壓測的方案設計和很好實踐,這些技術能夠全麵保證大規模、高並發項目的一緻性、可用性和高並發性;然後講解瞭大規模服務的日誌係統的原理、設計與實踐,包括ELK等框架的特點和使用方式等,並介紹瞭當前流行的APM係統的設計與實現,主要包括調用鏈和業務鏈的跟蹤與恢復,涵蓋瞭綫上等 李艷鵬,楊彪 著 李艷鵬,現任易寶支付産品中心首席架構師,曾在花旗銀行、甲骨文、路透社、新浪微博等大型IT互聯網公司擔任技術負責人和架構師,現專注於大規模、高並發的綫上和綫下支付平颱的應用架構和技術架構的規劃與落地,負責交易、支付、渠道、齣款、風控、對賬等核心支付係統的設計與實現,對移動支付、聚閤支付、閤規賬戶、掃碼支付、標記化支付等業務場景有産品應用架構規劃與落地的實踐經驗。
楊彪,現任某創業公司技術總監及閤夥人,在互聯網和遊戲行業有近10年工作經驗,曾在酷我音樂盒、人人遊戲和掌趣科技等上市公司擔任核心研發職位,在互聯網公司做過日活躍用戶量達韆萬的項目,也在遊戲公司做過多款月流水韆萬以上的遊戲。喜歡研等

《分布式服務架構》 引言 在當今互聯互通的信息時代,軟件係統正變得越來越復雜,其規模和影響力也日益增長。單一的、單體的應用程序已經難以滿足現代業務對高可用性、高並發性、易伸縮性以及快速迭代的需求。分布式服務架構應運而生,它將復雜的係統拆解成一係列獨立、自治的服務,通過網絡進行通信和協作,從而應對這些挑戰。 本書並非探討“分布式服務架構”這一概念本身,而是深入剖析在實際構建和演進分布式服務係統過程中,那些至關重要、常常被忽略,卻又直接影響係統成敗的核心技術實踐、設計原則與工程考量。它將帶領讀者穿越理論的迷霧,聚焦於那些在海量並發、網絡波動、服務故障等復雜場景下,能夠支撐係統穩定運行、高效迭代的工程智慧與落地經驗。 第一部分:基石 — 服務化與通信 在分布式係統中,將龐大的單體應用分解為更小、更易於管理的服務是第一步。但這僅僅是開始。如何有效地讓這些服務“說話”,如何保證它們的對話既高效又可靠,是係統能否正常運轉的關鍵。 服務拆分的藝術與陷阱:本書將詳細闡述服務拆分時需要遵循的設計原則,例如“高內聚、低耦閤”、“按業務域拆分”等。但更重要的是,我們將深入探討拆分過程中常見的“陷阱”,例如過度拆分導緻的管理復雜度爆炸,以及服務邊界定義不清帶來的技術債務。我們將提供一係列評估服務拆分閤理性的方法論,幫助讀者在實際操作中做齣明智的決策,避免“拆瞭等於沒拆”,或者“拆瞭比原來更麻煩”的窘境。 RPC框架的深度解析與選型:遠程過程調用(RPC)是服務間通信的常見方式。本書不會僅僅列舉市麵上的RPC框架,而是會從通信協議、序列化/反序列化機製、連接管理、負載均衡策略、容錯機製等多個維度,深入分析不同RPC框架的優劣。我們將探討gRPC、Thrift、Dubbo等主流框架在實際應用中的性能錶現、擴展性、以及易用性上的差異,並提供一套基於實際場景的選型指南,幫助讀者根據自身業務需求、技術棧特點、團隊能力選擇最適閤的RPC框架,而不是盲目追隨潮流。 RESTful API的設計哲學與實踐:除瞭RPC,RESTful API因其通用性和跨平颱性,在許多服務間通信場景中也扮演著重要角色。本書將不僅僅講解RESTful API的設計規範,更會強調資源建模的閤理性、HTTP動詞的正確使用、狀態碼的語義化、以及API版本控製策略。我們還將探討如何通過GraphQL等新技術來優化API的靈活性和效率,並分享在設計和維護大量API時,如何保證其一緻性、可發現性以及良好的文檔支持。 消息隊列的異步通信模式:在需要解耦、削峰填榖、異步處理的場景下,消息隊列是不可或缺的利器。本書將深入剖析RocketMQ、Kafka、RabbitMQ等主流消息隊列的核心設計理念,包括消息持久化、消費者消費模式(Push/Pull)、重復消費問題、順序消費保證、以及消息事務等。我們將通過大量的實例,講解如何利用消息隊列構建健壯的異步處理流程,提高係統的吞吐量和響應速度,同時規避消息丟失、重復等風險。 第二部分:可靠性 — 容錯與可用性 分布式係統最大的敵人之一就是“故障”。網絡延遲、服務崩潰、甚至整個數據中心的宕機,都可能對係統的可用性造成毀滅性打擊。本書將聚焦於如何在設計和實現層麵,構建能夠抵禦這些故障的“堅固防綫”。 服務降級與熔斷的策略與實現:當係統負載過高或部分服務發生故障時,如何有損地保證核心功能的可用性?本書將深入講解服務降級和熔斷的各種策略,如超時熔斷、異常比例熔斷、慢調用熔斷等,並重點分析Sentinel、Hystrix等熔斷降級組件的內部原理和實際應用。我們將提供一套係統性的方法,幫助讀者設計齣既能保護係統免受雪崩效應影響,又能最小化業務損失的降級方案。 重試機製的設計與權衡:服務調用失敗是常態,閤理的重試機製可以極大地提高係統的魯棒性。本書將詳細探討固定間隔重試、指數退避重試、帶有抖動的重試等不同策略的適用場景,並重點分析在分布式環境中,重試可能帶來的冪等性問題、堆積效應等潛在風險。我們將提供一套完整的重試機製設計框架,確保重試不僅能解決問題,還能避免引入新的隱患。 分布式事務的挑戰與解法:在分布式環境下,保證跨多個服務的事務一緻性是一個巨大的挑戰。本書將深入剖析兩階段提交(2PC)、三階段提交(3PC)等傳統分布式事務的局限性,並重點介紹TCC(Try-Confirm-Cancel)、Saga模式等更適閤高並發場景的解決方案。我們將通過真實的業務場景,講解如何設計和實現一套能夠兼顧一緻性、可用性和性能的分布式事務方案。 優雅停機與平滑升級:在進行係統維護、版本更新時,如何做到“零停機”?本書將詳細講解優雅停機的實現方式,包括如何讓服務在收到停止信號後,完成當前正在處理的請求,並將新請求導嚮其他健康實例。同時,我們還將探討藍綠部署、金絲雀發布等平滑升級的策略,幫助讀者在不影響用戶體驗的前提下,實現係統的平滑演進。 第三部分:效率 — 擴展性與性能優化 隨著業務的發展,用戶量的激增、數據量的增長,對係統的性能和可擴展性提齣瞭嚴峻的考驗。如何讓係統能夠輕鬆應對流量洪峰,並隨著業務增長而不斷擴展,是分布式架構設計的核心目標之一。 負載均衡的進階技巧:負載均衡不僅僅是將請求分發到不同的服務器,更關乎係統的整體效率和穩定性。本書將深入剖析輪詢、隨機、最少連接、加權輪詢等基礎負載均衡算法,並重點介紹基於響應時間的自適應負載均衡、基於地理位置的負載均衡、以及HTTP/2的連接復用等進階技巧。我們將通過實際案例,講解如何根據不同的業務場景和服務器特性,選擇和優化負載均衡策略。 服務注冊與發現的模式與實踐:服務注冊與發現是分布式係統中服務間通信的基礎設施。本書將深入分析ZooKeeper、Etcd、Consul等服務注冊與發現中心的工作原理,並探討客戶端發現、服務端發現等不同模式的優劣。我們將分享在實際大規模部署中,如何保證服務注冊與發現的高可用性、低延遲性、以及數據一緻性。 緩存策略的設計與失效規避:緩存是提升係統性能的常用手段,但設計不當的緩存會帶來數據不一緻的風險。本書將深入講解本地緩存、分布式緩存(Redis, Memcached)的設計原則,包括緩存失效策略(TTL、LRU、LFU)、緩存穿透、緩存擊穿、緩存雪崩等問題的解決方案。我們將提供一套完整的緩存設計與優化指南,幫助讀者在享受緩存帶來的性能提升的同時,規避潛在的數據風險。 數據分片與存儲優化:隨著數據量的爆炸式增長,單一數據庫難以支撐海量數據的存儲和查詢。本書將深入講解讀寫分離、分庫分錶等數據分片策略,並詳細分析Hash分片、Range分片、以及一緻性Hash算法的原理和應用。我們將探討在進行數據遷移和分片時,如何保證數據的一緻性和業務的連續性,以及如何優化數據庫的查詢性能。 第四部分:管理 — 監控、日誌與運維 再完美的架構,也需要強大的監控和日誌係統來支撐其日常運行和故障排查。在復雜的分布式環境中,理解係統“發生瞭什麼”,定位“問題齣在哪裏”,是保障係統穩定性的關鍵。 分布式鏈路追蹤的實現與價值:在分布式係統中,一次請求可能穿越數十甚至上百個服務。鏈路追蹤能夠幫助我們可視化整個請求的處理流程,快速定位瓶頸和故障點。本書將深入講解Zipkin、Jaeger等鏈路追蹤係統的原理,以及如何在代碼層麵植入追蹤信息。我們將強調如何利用鏈路追蹤數據來優化服務性能、識彆潛在風險、以及提升故障排查效率。 集中式日誌係統的搭建與分析:海量的日誌數據是理解係統行為的寶貴財富。本書將詳細介紹ELK(Elasticsearch, Logstash, Kibana)等集中式日誌係統的搭建和使用,包括如何有效地收集、存儲、索引、搜索和分析日誌。我們將分享一係列實用的日誌分析技巧,幫助讀者快速從中挖掘有價值的信息,用於故障診斷、性能調優、以及安全審計。 係統監控與告警體係的建設:“看不見”的係統是危險的。本書將講解如何構建一套全麵、實時的係統監控體係,覆蓋基礎資源監控、應用性能監控(APM)、業務指標監控等各個層麵。我們將深入探討Prometheus、Grafana等監控工具的使用,並分享如何設計有效的告警規則,做到“防患於未然”,及時發現並處理潛在問題。 自動化運維與CI/CD流程:手動執行部署、配置、升級等操作在分布式係統中是不可持續的。本書將強調自動化運維的重要性,並探討Ansible、Chef、Puppet等自動化工具的應用。同時,我們將深入講解持續集成(CI)和持續部署(CD)的理念和實踐,幫助讀者構建高效、可靠的軟件交付流水綫,加速業務迭代。 結論 本書的目標並非提供一個“銀彈”式的分布式服務架構解決方案,而是希望通過對一係列核心技術和工程實踐的深入剖析,為讀者提供一套係統性的思維框架和實用的工具集。在瞬息萬變的分布式技術浪潮中,理解這些底層原理,掌握這些工程智慧,纔能真正構建齣健壯、可擴展、高性能的分布式服務係統,並在激烈的市場競爭中保持領先。本書適閤於有一定軟件開發經驗,希望深入理解和實踐分布式服務架構的開發者、架構師以及技術管理者。

用戶評價

評分☆☆☆☆☆

從設計哲學層麵來看,這本書的格局明顯高於市麵上許多專注於特定框架或工具的書籍。它仿佛在教你如何“思考”而不是“編碼”。我特彆欣賞其中關於“領域驅動設計(DDD)”與微服務邊界劃分的討論。作者強調,技術選型必須服從於業務領域模型,不恰當的邊界劃分是導緻分布式係統災難的罪魁禍首。書中對“限界上下文”的刻畫細緻入微,結閤瞭多個復雜業務場景的案例,展示瞭如何通過“聚閤根”來封裝不變量,確保數據在服務間的流動是可控且有意義的。這種對軟件本質的深刻洞察,讓我開始反思我們團隊過去那種粗暴地按功能模塊劃分服務的做法帶來的耦閤問題。閱讀完後,我感覺自己對係統設計不再僅僅停留在組件和連接的層麵,而是上升到瞭對信息流、職責分離和組織結構映射的更宏觀的理解,這對於構建一個真正鬆耦閤、高內聚的係統至關重要。

評分☆☆☆☆☆

我通常對技術書籍抱有一種審慎的態度,因為很多書籍往往隻描述瞭“What”,卻鮮有觸及“Why”和“How”。然而,這本關於架構的著作在這方麵做得尤為齣色。它沒有僅僅羅列那些時髦的架構模式——比如SAGA、CQRS或者Event Sourcing——而是花瞭大量篇幅去剖析這些模式産生的“病竈”,也就是分布式係統固有的復雜性、網絡延遲和分區容錯的挑戰。作者的敘事方式非常引人入勝,他似乎在引導讀者進行一場思維實驗,從最簡單的兩階段提交(2PC)的睏境齣發,逐步推導齣最終一緻性方案的必要性。這種由淺入深、邏輯嚴密的推導過程,極大地加深瞭我對CAP理論和BASE理論在實際應用中取捨的理解。它不是讓你死記硬背理論,而是讓你在腦海中構建起一套完整的分布式思維模型,能夠根據不同的業務需求,主動去權衡和設計齣最閤適的架構藍圖,這對於提升架構師的內功是至關重要的。

評分☆☆☆☆☆

這本書的實戰性真的讓我感到驚喜,它沒有停留在那些高屋建瓴的概念層麵,而是非常紮實地深入到瞭具體的技術選型和實施細節中。比如,在處理微服務間的通信問題時,作者沒有簡單地推薦某種工具,而是對比瞭RPC和RESTful API的優劣,並結閤實際項目場景分析瞭何時應該優先考慮異步消息隊列的引入,以及如何設計冪等性來保證數據一緻性。尤其讓我印象深刻的是關於服務治理那一章,它詳細闡述瞭熔斷、降級和限流這“三駕馬車”的原理和代碼實現思路,甚至提到瞭如何在Spring Cloud生態下集成Sentinel或Hystrix(盡管後者已不再活躍,但其思想的闡述非常有價值)。對於一個正在從單體應用嚮分布式轉型,或者已經在微服務泥潭中掙紮的工程師來說,這種手把手的指導簡直是雪中送炭。它不是那種教科書式的理論堆砌,而是充滿瞭“踩坑”後的經驗總結,讀起來讓人感覺作者就在身邊親自指導,每一個技術決策背後都有充分的理由支撐,大大提高瞭我在團隊內部推動架構升級的底氣和效率。

評分☆☆☆☆☆

這本書的排版和語言風格齣乎意料地平實且富有感染力。雖然主題是高深莫測的分布式係統,但作者的文字功底使得復雜的概念也能被清晰、直觀地錶達齣來。閱讀體驗非常流暢,沒有那種拗口的技術術語堆砌感。我尤其喜歡作者在關鍵技術點插入的那些“過來人的忠告”——那些看似隨性卻一針見血的建議,比如“過度設計是架構師的慢性病”或者“先跑起來,再跑得好,最後跑得穩”。這些並非硬性技術規範,卻極大地影響瞭我的實踐心態。它教會我,架構是一個持續演進的過程,而非一次性完成的工程。這種對工程實踐中人性、項目壓力和技術局限性的深刻理解,使得整本書讀起來充滿瞭人情味和實操價值,讓人願意一口氣讀完,並且讀完後不是扔在一邊,而是會反復翻閱那些重點章節,對照自己的項目進行審視和調整。

評分☆☆☆☆☆

我關注這本書的一個主要原因是想瞭解在新一代雲原生技術棧下,傳統分布式問題的解決思路是否發生瞭根本性變化。這本書在這方麵提供瞭非常及時的更新。它不僅講解瞭Zookeeper、etcd等基礎組件的協調原理,還深入探討瞭服務網格(Service Mesh)如Istio在解決跨服務安全、可觀測性和流量管理方麵的潛力與挑戰。特彆是對“可觀測性”這一主題的探討,它清晰地梳理瞭日誌(Logging)、指標(Metrics)和追蹤(Tracing)三者如何協同工作,以及如何利用OpenTelemetry等標準來打通數據孤島。這種對新興技術的接納和批判性分析,使得全書的內容既有堅實的理論基礎,又緊跟行業前沿。它不是簡單地介紹Istio的CRUD操作,而是闡述瞭Sidecar模式背後的性能權衡,以及在復雜網絡環境下,如何設計高效的分布式追蹤鏈路。對於希望將架構設計能力從虛擬機時代過渡到容器和Serverless時代的工程師來說,這本書提供瞭非常寶貴的橋梁和路綫圖。

評分☆☆☆☆☆

還可以

評分☆☆☆☆☆

好東西,值得擁有,不錯不錯?

評分☆☆☆☆☆

好東西,值得擁有,不錯不錯?

評分☆☆☆☆☆

此用戶未填寫評價內容

評分☆☆☆☆☆

好東西,值得擁有,不錯不錯?

評分☆☆☆☆☆

好書,瞭解瞭很多知識

評分☆☆☆☆☆

書很好,比電子版看著舒服

評分☆☆☆☆☆

好的,喜歡,給員工作為禮物的 ,可以

評分☆☆☆☆☆

書很好,比電子版看著舒服

相關圖書