
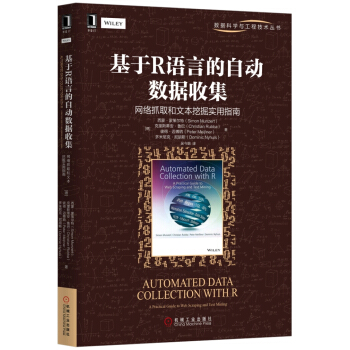

具体描述
编辑推荐
本书重点阐释自动化数据抓取和分析技术,适用于初中级用户。作者以简洁的代码、详细的讲解以及真实的案例,分析了大数据在社会科学领域的运用。作者尽可能回避晦涩的术语和高深的理论,通过非常实用的组件探讨很多有趣的实际问题。这种深入浅出的讲解方式有利于我们快速上手,在循序渐进中学习,并能把学到的技术应用到实际研究项目中。
本书特色:
提供关于网络抓取和文本挖掘的实用指南,既适合R的初学者,也适合有经验的用户。
讲解互联网上通信、交换、保存和显示信息的基础技术(如HTTP、HTML、XML、JSON、AJAX、SQL等)。
探索查询网络文档和数据集的基本技术(XPath及正则表达式),以及从动态HTML采集信息的技术。
提出数据抓取和管理的实用工作流,包括从选择正确的方法到优化代码以及维护抓取程序。
以案例分析为特色,每种技术都辅以详细的案例解析。
提供大量练习题,帮助读者深入学习与总结每项技术。
内容简介
本书由资深社会科学家撰写,从社会科学研究角度系统且深入阐释利用R语言进行自动化数据抓取和分析的工具、方法、原则和实践。作者深入剖析自动化数据抓取和分析各个层面的问题,从网络和数据技术到网络抓取和文本挖掘的实用工具箱,重点阐释利用R语言进行自动化数据抓取和分析,能为社会科学研究者与开发人员设计、开发、维护和优化自动化数据抓取和分析提供有效指导。
本书共17章,第1章是概述,阐述数据挖掘的意义与实际应用。第2~8章介绍网络和数据技术基础知识,内容涉及互联网上通信、交换、保存和显示信息的基础技术(如HTTP、HTML、XML、JSON、AJAX、SQL等),并讲解用于查询网络文档和数据集的基本技术(XPath和正则表达式)。第9~11章介绍网络抓取和文本挖掘的实用工具箱,其中第9章讲解多种网络抓取技术,涉及正则表达式的使用、XPath、各类API接口、其他数据类型以及开源社区相关的技术;第10章深入介绍用于统计性文本处理的技术;第11章给出关于用R管理数据的项目中常见问题的一些见解。第12~17章介绍实际案例分析,涉及美国参议院里的合作网络、从半结构化文档解析信息、利用Twitter预测2014年奥斯卡奖、绘制姓氏地理分布图、采集关于手机的数据、分析产品评论里的情绪等。这些案例分析针对日常的数据抓取和文本处理的工作流程、真实环境数据中的陷阱以及规避它们的方法等问题提供一些实用的见解。
目录
译者序前 言
第1章概述
1.1案例研究:濒危世界遗产地
1.2有关网络数据质量的一些讨论
1.3传播、提取和保存网络数据的技术
1.3.1在网络上传播内容的技术
1.3.2从Web文档中提取信息的
技术
1.3.3 数据保存的技术
1.4本书的结构
第一部分网络和数据技术入门
第2章HTML
2.1浏览器显示及源代码
2.2语法规则
2.2.1标签、元素和属性
2.2.2树形结构
2.2.3注释
2.2.4保留字符和特殊字符
2.2.5文档类型定义
2.2.6 空格和换行
2.3标签和属性
2.3.1 锚标签
2.3.6 标题标签、
、
等
2.3.7 通过、和
列举内容
2.3.8组织型标签和
2.3.9 标签及其同伴
2.3.10 外部脚本标签
- 和
列举内容
2.3.8组织型标签和
2.3.9 标签及其同伴
2.3.10 外部脚本标签
前言/序言
用户评价
作为一名渴望提升自己数据分析技能的在校研究生,我一直在寻找一本能够帮助我快速入门网络抓取和文本挖掘的书籍。我对R语言已经有一些基础了解,能够进行一些基本的数据处理和统计分析,但每次面对需要从互联网上搜集大量数据进行研究时,都感到力不从心。手动复制粘贴效率太低,而且容易出错,这极大地影响了我的研究进度。而“基于R语言的自动数据收集:网络抓取和文本挖掘实用指南”这个书名,让我眼前一亮。它精准地戳中了我的学习需求。我非常好奇这本书会如何将R语言这门强大的工具应用到这两个看似复杂的领域。我希望这本书能从零开始,详细讲解如何使用R语言的各种包来实现网络抓取,比如如何发送HTTP请求,如何解析HTML、XML等网页结构,以及如何处理各种复杂的网页布局和动态加载的内容。更重要的是,我期待书中能够深入探讨文本挖掘的各个环节,包括如何进行文本的清洗、预处理,如中文分词、词性标注、停用词去除、词形还原等,以及如何使用R语言的强大文本挖掘包来构建词频矩阵、进行TF-IDF计算、实现情感分析、主题建模(如LDA)、关键词提取等。如果书中能提供丰富的实战案例,例如分析微博评论的情感倾向,或者从新闻报道中提取热门话题,那就再好不过了。我希望这本书能够让我掌握一套完整的工作流程,从而独立完成更具挑战性的数据研究项目。
评分在我看来,一本好的技术书籍,其价值不仅仅在于传授知识,更在于能够激发读者的学习兴趣,并帮助他们建立起解决实际问题的能力。“基于R语言的自动数据收集:网络抓取和文本挖掘实用指南”这个书名,传递了一种实用主义和技术导向的信号,这让我对它充满了期待。我之前也接触过一些关于网络抓取和文本挖掘的书籍,但很多要么过于理论化,要么案例不够贴切,导致学习过程枯燥乏味,难以转化为实际操作。我希望这本书能够以一种更加生动、易懂的方式来讲解这些内容。比如,在讲解网络抓取时,能否用一些生动的比喻来解释HTTP请求、HTML解析等概念?在介绍文本挖掘时,能否通过有趣的案例来展示其强大的应用潜力?我非常看重书籍的“实用性”,希望它能提供可以直接拿来就用的代码示例,并且能够解释这些代码的逻辑和原理,让读者知其然也知其所以然。同时,我也希望这本书能够涵盖一些进阶的内容,比如如何构建更复杂的爬虫,如何处理大规模数据,以及如何结合机器学习模型来进行更深入的文本分析。如果书中还能给出一些关于数据伦理和隐私保护的提示,那就更显人性化和专业了。总而言之,我期待这本书能够成为我手中一份宝贵的参考工具,指引我在这两个热门领域不断探索和成长。
评分我是一名初入职场的数据分析师,虽然在工作中接触了R语言,也完成了一些基础的数据报表和可视化工作,但总觉得自己的技能还不够全面,尤其是在处理非结构化数据方面存在明显的短板。很多时候,我们需要从各种新闻网站、论坛、社交媒体等渠道获取信息,而这些信息往往以文本的形式存在,并且需要通过网络抓取才能获得。我一直想学习如何高效地从这些渠道自动收集数据,并利用文本挖掘技术来提炼有价值的信息。这本书的标题“基于R语言的自动数据收集:网络抓取和文本挖掘实用指南”正是我所急需的。我希望这本书能够提供一种系统性的学习路径,让我能够理解网络抓取的原理,并掌握如何使用R语言中的常用库,例如`rvest`、`RCurl`等,来实现网页数据的爬取。同时,我也希望书中能够详细介绍文本挖掘的核心概念和技术,比如如何进行文本预处理(包括中文分词、去停用词、词干提取等),以及如何应用NLP(自然语言处理)技术,如情感分析、主题模型、实体识别等,来挖掘文本中的深层含义。如果书中能提供一些贴近实际业务场景的案例,例如分析用户评价来改进产品,或者追踪舆情来把握市场动态,那就更好了。我希望通过这本书的学习,能够显著提升我处理和分析非结构化数据的能力,为我的职业发展打下坚实的基础。
评分这本书的书名非常吸引人,“基于R语言的自动数据收集:网络抓取和文本挖掘实用指南”。一看到这个名字,我作为一名在数据分析领域摸爬滚打多年的老兵,就深感共鸣。在我刚接触数据分析的时候,手动收集数据是多么耗费时间和精力的事情,简直是一场噩梦。我记得有一次为了收集一个特定的行业报告,我翻遍了各种网站,复制粘贴,手动整理,耗费了整整一周的时间,而且数据质量参差不齐,错误百出。那时候我就在想,有没有一种方法可以自动化这个过程,让我能把更多的时间投入到更有价值的分析和洞察中。而这本书的书名恰恰点出了我一直以来追求的痛点和解决方案。R语言本身就是数据科学领域的利器,强大的统计分析能力和丰富的可视化库,早已为我所熟知。如果能将R语言与网络抓取和文本挖掘结合起来,那将是如虎添翼。我迫切地希望这本书能够提供一套系统性的方法论,从最基础的网络爬虫搭建,到如何从抓取到的海量非结构化文本中提取有用的信息,再到如何利用R语言的强大功能对这些信息进行分析和解读,都能有详细的讲解和实用的案例。我期待能够学习到如何优雅地处理各种网络数据源,如何应对反爬机制,如何进行文本预处理(分词、去停用词、词干提取等),以及如何运用各种文本挖掘技术(情感分析、主题模型、关键词提取等)来发现数据背后的故事。这本书如果能做到这一点,那绝对是数据从业者的福音。
评分长久以来,我都对互联网上的海量信息充满好奇,但受限于自身的技术能力,很多时候只能望洋兴叹。我深知,在当今大数据时代,能够高效地从网络中获取数据并对其进行深度分析,是一项极其重要的技能。而“基于R语言的自动数据收集:网络抓取和文本挖掘实用指南”这个书名,无疑为我打开了一扇新的大门。我希望这本书能够提供一套完整且易于理解的R语言解决方案,来解决我在数据收集和分析过程中遇到的瓶颈。我期待书中能够详细阐述如何使用R语言构建健壮的网络爬虫,包括如何应对动态网页、API接口以及反爬机制等常见挑战。更重要的是,我希望它能深入讲解文本挖掘的核心技术,例如如何利用R语言进行文本预处理(分词、词性标注、去除噪声等),如何进行情感分析、主题建模、关键词提取等,以及如何将这些技术应用于实际问题解决。我渴望通过这本书的学习,能够掌握一套完整的自动化数据收集和文本分析流程,从而能够独立完成一些有价值的研究项目,例如分析用户对某个产品的评价趋势,或者挖掘社交媒体上的热门话题。如果书中能够提供一些循序渐进的练习和实际案例,能够让我边学边练,巩固所学知识,那将是极大的帮助。我希望这本书能够成为我通往数据分析领域的一块坚实基石。
评分ok
评分这一系列的图书不错,有参考价值,相信出版社。
评分读书写字是人生必须的 修身养性
评分还在学习中,正品书,买书一直在京东
评分不错,想正版
评分收到货了,感觉还不错的
评分不错
评分这本书包装非常精美,外面的塑封包装很完整,还没有打开,看里面内容应该还不错
评分还在学习中,正品书,买书一直在京东
相关图书






本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等,本站所有链接都为正版商品购买链接。
© 2026 windowsfront.com All Rights Reserved. 静流书站 版权所有